이 글은 이전 글 'Classifier와 LLM 사이의 빈자리: Jev를 통해 다시 생각한 AI의 판단'
https://blog.wookingwoo.com/88
Classifier와 LLM 사이의 빈자리: Jev를 통해 다시 생각한 AI의 판단
이 글은 WikiDocs의 Decision AI와 Jev를 읽고, 인상 깊었던 내용을 바탕으로 작성한 글입니다. 최근 Jev라는 조금 특이한 AI 모델을 알게 됐다.처음에는 TypeSafe AI가 만든, 일반적인 LLM처럼 문장을 생성하
blog.wookingwoo.com
을 쓰고 나서 생긴 기술적인 궁금증에서 시작했다.
지난 글에서는 Jev를 계기로 Classifier와 LLM 사이에 어떤 빈자리가 있는지 생각해봤다.
Classifier는 빠르고 확률을 주지만 문제 정의가 학습 시점에 고정되기 쉽고, LLM은 runtime에 질문과 선택지를 자유롭게 바꿀 수 있지만 생성이라는 더 큰 문제를 풀고 있다.
그렇게 정리하고 나니 오히려 새로운 궁금증이 생겼다.
둘은 기술적으로 대체 무엇이 다른 걸까?
LLM이 "billing"이라고 답할 때 내부에서는 무슨 일이 벌어지고 있을까?
Decision Model은 어떻게 텍스트를 생성하지 않고 곧바로
billing     0.93
technical   0.05
sales       0.02
같은 결과를 만들 수 있을까?
그리고 그 0.93이라는 숫자는 어디서 오는 걸까?
이번에는 개념에서 한 단계 더 내려가, 실제 공개 코드가 있는 Laya를 뜯어보면서 이 질문에 답해보려고 한다.
먼저 선을 하나 긋고 시작하자: Jev와 Laya는 같은 모델이 아니다
TypeSafe는 2026년 9월 15일 Jev를 공개하면서 System One Model을 unstructured state를 받아 typed probabilistic decision을 반환하는 모델로 설명했다. 공개된 설명에는 새로운 model architecture, parallel sampler, 그리고 **RLCD(Reinforcement Learning for Calibrated Decisions)**라는 학습 방향이 등장한다.
하지만 Jev가 정확히 어떤 backbone을 쓰는지, option probability를 어떤 head에서 만드는지, RLCD reward가 어떤 식으로 계산되는지는 공개된 정보만으로 알 수 없다.
반면 Laya는 Apache 2.0으로 코드와 웨이트가 공개된 독립 프로젝트다. Laya는 2026년 9월 18일 PyPI에 처음 공개됐으므로 Jev보다 먼저 나온 모델도 아니다.
그럼에도 Laya를 보는 이유는 분명하다.
Decision Model이라는 아이디어가 실제 코드에서는 어떤 모습이 될 수 있는지 끝까지 관찰할 수 있기 때문이다.
현재 영어 Laya checkpoint는 ModernBERT-large를 backbone으로 사용하고, custom decision head를 더해 총 약 421M parameter로 구성된다. ModernBERT-large 자체는 약 395M parameter의 bidirectional encoder다.
따라서 이번 글의 질문은
"Jev 내부가 이렇게 생겼다"
가 아니라,
"LLM과 다른 typed decision model을 만든다면 실제로 어떻게 구현할 수 있을까? Laya는 그 문제를 어떻게 풀었을까?"
에 가깝다.
LLM은 실제로 무엇을 예측하고 있을까?
먼저 LLM부터 다시 보자.
일반적인 decoder-only LLM의 기본 학습 목표는 다음 token 예측이다.
문장이
결제가 두 번 됐습니다.
라고 있을 때 모델이 직접 예측하는 것은 "이 문의의 부서는 billing이다"가 아니다.
현재까지 들어온 token을 바탕으로 다음에 어떤 token이 등장할지에 대한 확률분포를 만든다.

아주 단순화하면 다음 과정이다.
입력 token
   ↓
Embedding
   ↓
Decoder Transformer
   ↓
Vocabulary 전체에 대한 logits
   ↓
Softmax
   ↓
다음 token 선택
   ↓
선택한 token을 다시 입력에 추가
   ↓
다음 token 예측
   ↓
반복
예를 들어 우리가
다음 문의를 분류해줘.

billing / technical / sales

문의: 결제가 두 번 됐습니다.
라고 요청했을 때 최종 출력이 billing일 수 있다.
하지만 모델 입장에서 처음부터
billing     0.93
technical   0.05
sales       0.02
라는 세 개의 업무 선택지를 직접 비교한 것은 아니다.
모델이 기본적으로 만드는 확률분포의 공간은 내가 정의한 세 개의 label이 아니라 vocabulary의 다음 token들이다.
그리고 한 token을 선택한 뒤 또 다음 token을 예측한다.
이 때문에 이런 모델을 autoregressive model이라고 부른다.
Structured Output을 사용하면 Decision Model과 같아지는 걸까?
요즘 LLM에는 JSON Schema나 Structured Output 기능이 있으니 이런 의문도 생긴다.
{
  "department": "billing"
}
형태로 강제할 수 있다면 결국 typed decision과 같은 것 아닐까?
출력 인터페이스만 보면 비슷해질 수 있다.
하지만 일반적인 decoder LLM에서 내부 추론 방식까지 바뀌는 것은 아니다.
Structured Output 구현은 흔히 constrained decoding을 사용한다. 현재 schema에서 허용되지 않는 token을 막으면서 JSON을 생성하게 만드는 식이다.
그래도 본질적인 흐름은 여전히
다음 token의 logits
→ 허용 가능한 token 제약
→ token 선택
→ 다음 token
→ ...
이다.
즉 generation의 자유도를 제한한 것이지, 처음부터 user-defined option distribution을 직접 계산하는 decision head가 된 것은 아니다.
물론 LLM의 token log probability를 이용해 특정 candidate의 점수를 계산하는 방법도 있다. 따라서 "LLM으로는 decision probability를 만들 수 없다"는 뜻은 아니다.
다만 여러 token으로 이루어진 label의 확률을 어떻게 합칠지, candidate 간 점수를 어떻게 정규화할지, 그 값이 실제 task-level correctness와 calibration되어 있는지는 별개의 문제다.
이 차이를 이해하고 Laya를 보면 구조가 훨씬 선명해진다.
Laya는 다음 token이 아니라 선택지를 점수화한다
Laya의 코드를 보면 입력 구성부터 다르다.
**build_sequence()**는 질문 하나를 대략 다음 형태의 token sequence로 만든다.
[CLS]
choice question: Which department should handle this?
[SEP]

[MASK] billing: invoices, payments, refunds
[MASK] technical: bugs, outages, errors
[MASK] sales: pricing, contracts
[SEP]

결제가 두 번 됐습니다. 환불해주세요.
[SEP]
여기서 처음 봤을 때 가장 헷갈렸던 것이 **[MASK]**였다.
BERT에서 [MASK]를 봤다면 보통 "가려진 단어를 맞히는 위치"를 떠올리기 때문이다.
그런데 Laya에서는 역할이 다르다.
[MASK]는 각 선택지를 대표하는 marker다.
[MASK] billing ...
  ↑
billing의 marker

[MASK] technical ...
  ↑
technical의 marker

[MASK] sales ...
  ↑
sales의 marker
Laya는 나중에 이 marker 위치의 hidden state를 꺼내 각각 점수를 매긴다.
즉 선택지의 이름과 설명 자체가 모델의 입력으로 들어간다.
이 부분에서 지난 글의 "Classifier와 LLM 사이의 빈자리"가 기술적으로 조금 보이기 시작했다.
Bidirectional Encoder: 전체 문제를 한 번에 읽는다
Laya 영어 모델의 backbone은 ModernBERT-large다.
ModernBERT는 GPT 계열과 같은 causal decoder가 아니라 bidirectional encoder다.
Decoder-only LLM에서 causal attention을 단순화하면 다음과 같다.
token 1
token 2 ← token 1
token 3 ← token 1, 2
token 4 ← token 1, 2, 3
다음 token을 예측해야 하기 때문에 아직 나오지 않은 미래 token은 볼 수 없다.
반면 bidirectional encoder는 이미 주어진 전체 입력을 함께 읽을 수 있다.
question
   ↕
billing option
   ↕
technical option
   ↕
sales option
   ↕
customer state
따라서 billing marker의 representation을 만들 때도 질문과 state뿐 아니라 다른 선택지의 의미까지 함께 고려할 수 있다.
ModernBERT 자체도 classification과 retrieval 같은 encoder 작업에서 효율성을 높이는 것을 목표로 만들어진 모델이다.
실제 Laya forward를 따라가보자
Laya의 **DecisionModel.forward()**를 단순화하면 꽤 직관적이다.
1. 전체 sequence를 encoder에 넣는다
input_ids
   ↓
ModernBERT
   ↓
h₁, h₂, h₃, ... hₙ
각 token 위치마다 contextual hidden state가 생긴다.
2. 질문 타입을 embedding으로 추가한다
Laya에는 세 가지 question type이 있다.
- choice
- score
- noul
코드에는 이 세 타입을 위한 type embedding이 있고, encoder 결과 전체에 해당 질문 타입의 embedding을 더한다.
즉 같은 문장이어도
"여러 개 중 하나를 골라라"
와
"순서가 있는 점수를 매겨라"
라는 task 성격을 추가적으로 알려주는 셈이다.
3. custom decision head를 한 번 더 통과한다
기본 설정에서는 그 위에 2개의 Transformer Encoder layer로 구성된 decision head가 올라간다.
ModernBERT hidden states
       ↓
Question-type embedding
       ↓
2-layer Transformer decision head
4. 각 option marker 위치의 hidden state만 뽑는다
아까 저장해둔 [MASK] marker의 위치를 이용한다.
h_billing
h_technical
h_sales
5. 모든 option에 같은 scorer를 적용한다
현재 코드의 scorer는 개념적으로 다음 구조다.
hidden state
    ↓
LayerNorm
    ↓
Linear
    ↓
GELU
    ↓
Linear
    ↓
scalar logit
그래서 결과적으로
billing     → 4.2
technical   → 1.1
sales       → -0.3
같은 scalar logit을 얻는다.
6. temperature와 softmax를 적용한다
최종 확률은 logit을 temperature로 조정한 뒤 softmax해서 만든다.
$$
p_i =
\frac{\exp(z_i / T)}
{\sum_j \exp(z_j / T)}
$$
예를 들어
billing     0.94
technical   0.05
sales       0.01
이 된다.
여기에는 "billing"이라는 문자열을 token-by-token으로 생성하는 decoding loop가 없다.
핵심 흐름만 남기면 다음과 같다.
state + question + runtime options
              ↓
      Bidirectional Encoder
              ↓
        Decision Head
              ↓
   Option marker hidden states
              ↓
        Shared Scorer
              ↓
        Option logits
              ↓
     Temperature + Softmax
              ↓
   Probability distribution
가장 인상 깊었던 부분: class가 output에서 input으로 이동했다
이 구조를 보면서 지난 글에서 느꼈던 의문이 가장 많이 해소됐다.
전통적인 classifier를 아주 단순화하면 이런 구조다.
Encoder
  ↓
representation
  ↓
Linear(d → C)
  ↓
[class A, class B, class C]
class 개수 C가 output layer 구조에 포함된다.
예를 들어 원래
billing
technical
sales
세 개를 학습한 classifier에
security
를 새로 추가하고 싶다면 문제 정의 자체가 모델의 output head에 묶여 있다.
일반적으로 새로운 class의 데이터를 준비하고 모델을 다시 학습하는 과정이 필요하다.
Laya는 이 위치를 바꾼다.
[MASK] billing
[MASK] technical
[MASK] sales
[MASK] security
처럼 class definition을 runtime input으로 넣는다.
그리고 어떤 label이 들어오든 같은 scorer를 적용한다.
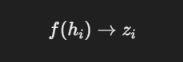
나는 이게 Laya 구조에서 가장 흥미로운 부분이었다.
전통적인 classifier에서 output layer에 고정되어 있던 taxonomy를 input으로 옮겼다.
그래서 새로운 선택지를 넣기 위해 classifier head 자체를 다시 만드는 것은 필요하지 않다.
이게 classifier의 probability interface와 LLM의 runtime flexibility 사이를 연결하는 한 가지 실제 구현 방법인 셈이다.
하지만 여기에는 중요한 단서가 있다.
architecture를 바꾸지 않아도 된다는 것과 새로운 domain에서 잘 맞힌다는 것은 전혀 다른 이야기다.
Laya가 공개한 typed-decisions 자체 benchmark에서 일반 영어 checkpoint는 accuracy 0.362였고, 해당 workflow에 fine-tuning한 checkpoint는 0.766을 기록했다. 이 수치는 Laya 측 자체 평가이므로 독립적인 성능 증명으로 받아들일 수는 없지만, 적어도 한 가지는 잘 보여준다.
runtime에 새로운 label을 넣을 수 있다는 것은 zero-shot으로 어떤 taxonomy든 잘 이해한다는 뜻이 아니다.
실제 제품에서는 여전히 domain data와 evaluation, 경우에 따라 fine-tuning이 필요하다.
Choice, Noul, Score는 생각보다 같은 구조다
처음에는 Choice, Noul, Score가 서로 전혀 다른 출력 방식처럼 느껴졌다.
코드를 보면 결국 모두 option distribution을 만든 뒤 어떻게 해석하느냐의 차이에 가깝다.
Choice
billing     0.94
technical   0.05
sales       0.01
가 나오면 가장 높은 확률의 label을 선택한다.
argmax(p) → billing
Noul
Noul은 사실상 내부적으로 두 선택지다.
false
true
예를 들어
false  0.07
true   0.93
이라면 반환하는 noul 값은 P(true) = 0.93이다.
Score
Score는 순서가 있는 option distribution을 만든다.
0 = 중요하지 않음
1 = 빠른 대응 필요
2 = 즉시 대응 필요
확률이
0 → 0.05
1 → 0.35
2 → 0.60
이라면 Laya는 score를 기대값으로 계산한다.
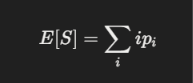
0 × 0.05 + 1 × 0.35 + 2 × 0.60
= 1.55
가 된다.
결국 세 primitive의 공통 기반은
option별 logit → probability distribution
이다.
그리고 그 distribution을 선택, yes probability, ordinal expectation 중 어떤 방식으로 읽을지만 달라진다.
그러면 왜 빠를 수 있을까?
여기까지 보면 Laya가 LLM보다 빠를 가능성이 높은 이유도 자연스럽게 보인다.
첫 번째는 모델 크기다.
영어 Laya는 총 약 421M parameter다. 현재의 대형 생성 모델과 비교하면 훨씬 작다.
두 번째는 encoder-only 구조다.
텍스트 생성을 위한 decoder가 아니라 전체 입력을 encoding하고 필요한 위치를 점수화한다.
세 번째가 가장 중요하다.
출력 token을 하나씩 생성하지 않는다
LLM이 30 token짜리 JSON을 생성한다면 개념적으로 다음 dependency가 생긴다.
Prefill
  ↓
Decode token 1
  ↓
Decode token 2
  ↓
Decode token 3
  ↓
...
  ↓
Decode token 30
token 30을 만들려면 앞의 결과들이 먼저 나와야 한다.
반면 Laya는 output token 자체가 없다.
option logit을 얻고 softmax하면 끝이다.
네 번째는 batching이다.
한 state에서 여러 질문을 평가한다면 Laya는 질문별 sequence를 여러 row로 만들어 한 batch forward에 넣을 수 있다.
다만 여기에는 중요한 nuance가 있다.
"한 번의 forward pass"라고 해서
state를 단 한 번 encode
→ 모든 질문이 hidden state를 공짜로 공유
하는 구조는 아니다.
현재 코드에서는 state를 tokenize하는 작업은 공유하지만, 각 질문마다
question + options + state
형태의 row를 만들고 이 row들을 batch로 모델에 넣는다.
즉 질문 수가 증가하면 계산량도 증가한다.
다만 질문마다 별도의 네트워크 요청을 하고 autoregressive하게 답을 생성하는 대신, GPU가 잘 처리할 수 있는 batch 형태로 병렬화한다는 차이가 있다.
Laya README가 공개한 T4 benchmark에서는 영어 checkpoint 단일 질문을 약 40ms 수준으로 보고하고 있지만, 이 수치는 프로젝트 자체 benchmark이므로 환경이 다른 모델의 API latency와 직접 비교하기보다는 구조적 특성을 이해하는 참고치로 보는 편이 맞다.
Probability가 있다고 해서 곧바로 Confidence를 믿을 수 있는 것은 아니다
여기서 지난 글에서 다뤘던 confidence 문제로 다시 돌아오게 된다.
softmax를 거치면 어쨌든 0~1 사이 probability는 나온다.
그런데
billing = 0.90
이라고 모델이 출력했다고 해서 비슷한 사례 100개 중 정말 90개를 맞힌다는 보장은 없다.
이 차이가 calibration이다.
이상적으로는
confidence ≈ 0.8인 예측 1,000개
            ↓
실제로 약 800개가 정답
이어야 한다. Laya도 이 문제를 별도로 처리한다.
Temperature Scaling: 답은 그대로 두고 확신의 세기를 조절한다
Laya inference에서는 raw logits에 temperature를 적용한 뒤 softmax한다.
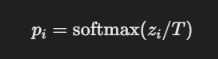
T가 1보다 크면 distribution이 더 평평해지고, 모델의 과도한 확신을 줄일 수 있다.
예를 들어
Before

billing     0.99
technical   0.01
가 calibration 후
After

billing     0.85
technical   0.15
처럼 될 수 있다.
a
rgmax인 billing은 그대로지만 얼마나 믿어야 하는지가 달라진다.
현재 Laya에는 question type과 option 수에 따라 다른 temperature를 적용할 수 있는 구조도 있다.
그리고 재미있는 점은 Laya 프로젝트 자체가 현재 공개 checkpoint들이 그대로는 over-confident할 수 있으므로 자신의 held-out data에서 temperature를 다시 fit하라고 명시한다는 것이다.
이건 중요한 사실이다.
RLCD로 학습했다고 해서 probability가 자동으로 완벽하게 calibrated되는 것은 아니다.
학습 목표로 calibration을 장려하는 것과, 실제 운영 domain에서 calibration이 검증됐다는 것은 다르다.
Confidence라는 단어도 하나의 값이 아니었다
Laya 코드를 보면서 의외였던 부분이 하나 더 있었다.
현재 API에는 answer_confidence와 confidence가 서로 다른 의미로 존재할 수 있다.
answer_confidence는 단순하다.

즉 실제로 반환한 답에 할당된 probability다.
반면 Choice와 Score의 confidence는 distribution 전체가 얼마나 한쪽으로 몰렸는지를 보는 normalized entropy를 사용한다.
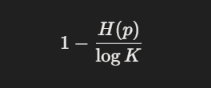
예를 들어
0.90 / 0.05 / 0.05
처럼 한쪽으로 몰려 있으면 높고,
0.34 / 0.33 / 0.33
처럼 퍼져 있으면 낮다.
둘 다 "확신"과 관련 있지만 의미가 다르다.
Laya 소스의 주석도 이 차이를 직접 경고한다.
temperature scaling과 ECE가 맞추려고 하는 것은 answer_confidence=max(p)이고, entropy 기반 confidence에 같은 threshold를 적용하면 안 된다.
지난 글에서는 단순히 "confidence를 control flow로 사용할 수 있다"고 생각했다.
이번에 코드를 보고 나니 한 단계 더 정확한 질문이 필요하다는 생각이 들었다.
그 confidence는 정확히 무엇을 측정하는 값인가?
이제 RLHF와 RLCD를 다시 보자
여기서 모델의 학습 목표까지 내려가면 LLM과 Decision Model의 차이가 더 흥미로워진다.
RLHF: 어떤 응답을 사람이 더 선호하는가
RLHF는 Reinforcement Learning from Human Feedback이다.
대표적인 고전 사례인 InstructGPT의 학습 과정을 단순화하면 다음과 같다.
Pretrained LLM
     ↓
사람이 작성한 좋은 응답으로 SFT
     ↓
같은 prompt에 여러 응답 생성
     ↓
사람이 응답 선호도 비교
     ↓
Reward Model 학습
     ↓
높은 reward를 받도록 policy 최적화
InstructGPT에서는 비교 데이터를 이용해 Reward Model을 만든 뒤 PPO로 policy를 최적화했다.
중심 질문은 대략 이런 것이다.
"사람이 어떤 응답을 더 선호하는가?"
물론 현대 LLM post-training이 모두 이 고전적인 PPO 기반 RLHF와 동일하다는 뜻은 아니다. DPO, RLVR 등 다양한 방법이 사용된다.
여기에서 중요한 건 human preference가 response-level reward signal이 되는 사고방식이다.
RLCD: distribution 자체를 잘 보고하도록 학습한다
TypeSafe는 Jev의 학습 방향을 **RLCD(Reinforcement Learning for Calibrated Decisions)**라고 부른다.
하지만 앞서 이야기했듯 Jev의 실제 reward function은 공개되어 있지 않다.
반면 Laya는 자신들이 구현한 RLCD를 코드로 공개한다.
다시 강조하면:
Laya의 RLCD 구현이 Jev의 RLCD 구현이라는 뜻은 아니다.
Laya의 구현에서는 model policy가 option에 대한 probability distribution을 보고하고, 그 distribution 자체를 strictly proper scoring rule로 평가한다.
현재 공개 코드의 기본 reward에는
- Log Score
- Spherical Score
- Score 같은 ordinal question을 위한 Ranked Probability Score
가 들어간다.
학습 설명에는 logit에 zero-mean Gaussian noise를 추가해 탐색하고, REINFORCE에 group-mean baseline을 사용하는 방식도 명시되어 있다. Multi-turn trajectory에는 TD(λ=1.0)을 사용한다.
이름은 모두 복잡해 보이지만 핵심은 한 문장으로 줄일 수 있다.
정답 label만 맞히는 것이 아니라, 정답에 얼마나 많은 probability를 줬는지도 reward에 직접 반영한다.
Proper Scoring Rule: 괜히 99%라고 자신만만하면 손해를 본다
가장 이해하기 쉬운 Log Score만 보자.
정답 option에 모델이 준 확률을 p_y라고 하면 reward의 한 부분은 다음과 같다.
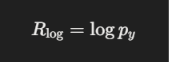
정답에 0.9를 줬다면
log(0.9) ≈ -0.105
다.
반면 모델이 자신만만하게 틀려서 실제 정답에는 0.01밖에 주지 않았다면
log(0.01) ≈ -4.605
가 된다.
큰 손해다. 이게 왜 중요할까?
실제로 어떤 유형의 문제에서 정답 분포가
billing 70%
sales   30%
라고 생각해보자.
모델 A:
billing 0.70
sales   0.30
모델 B:
billing 0.99
sales   0.01
둘 다 argmax는 billing이다.
accuracy만 평가한다면 billing이 정답인 사례에서는 둘 다 똑같이 1점을 얻는다.
하지만 같은 종류의 상황을 많이 반복하면 약 30%에서는 sales가 정답이 된다.
그때 0.99라고 과도하게 확신했던 B는 훨씬 큰 penalty를 받는다.
strictly proper scoring rule은 기대 reward를 최대화하려면 실제로 믿는 확률을 정직하게 보고하는 것이 유리하도록 설계된 규칙이다.
그래서 Laya의 RLCD에서는
어떤 답을 골랐는가?
뿐 아니라
각 답에 probability를 얼마나 줬는가?
자체가 학습 대상이 된다.
RLHF와 Laya의 RLCD를 비교하면
고전적인 RLHF 예시 Laya의 RLCD 구현
| 주요 출력 | Token sequence / response | Option probability distribution |
| 주요 feedback | Human preference | Decision target |
| Reward가 직접 보는 것 | 어떤 응답이 더 선호되는가 | 정답에 어떤 probability를 보고했는가 |
| Calibration | 핵심 목표로 직접 들어가지는 않음 | 명시적으로 장려 |
| 주 사용 방식 | 사람이 읽는 생성 결과 | 소프트웨어가 사용하는 typed decision |
이 표를 **"RLHF는 부정확하고 RLCD는 정확하다"**라는 의미로 읽으면 안 된다.
RLHF도 instruction following, usefulness, truthfulness 등 모델 행동을 크게 개선할 수 있다.
내가 중요하게 느낀 차이는 오히려 이것이다.
무엇을 reward하느냐가 모델이 제공하는 인터페이스의 성격을 바꾼다.
Response가 중요한 모델과 probability distribution 자체가 중요한 모델은 자연스럽게 다른 학습 목표를 가지게 된다.
Laya를 뜯어보면 장점의 원인이 곧 한계가 되기도 한다
오픈웨이트 모델을 보는 재미는 좋은 부분만 보이는 게 아니라는 점이다.
구조를 알면 어디에서 깨질 수 있는지도 보인다.
1. 선택지가 많아질수록 option도 context를 먹는다
Laya에서는 선택지 자체가 input에 들어간다.
각 option은 marker와 함께 token budget을 사용한다.
현재 build_sequence 코드는 option 하나를 처음에는 최대 48 token까지 사용하고, 전체 option이 head budget을 넘으면 각 option에 할당하는 길이를 더 줄인다.
많은 option이 비슷한 긴 prefix를 가지고 있다면 truncation 후 서로 구분되지 않는 token span이 될 수도 있다.
실제 코드에는 options_distinct를 계산해 이런 충돌을 감지하는 로직까지 추가되어 있다.
즉
class taxonomy를 runtime input으로 옮겼기 때문에 유연해졌지만, 그 taxonomy가 이제 context budget을 소비한다.
장점의 원인이 동시에 한계가 되는 셈이다.
2. 새로운 label을 넣을 수 있다고 zero-shot 성능이 보장되는 것은 아니다
앞서 본 것처럼 Laya 자체 benchmark에서도 general checkpoint와 domain-fine-tuned checkpoint의 차이가 크다.
runtime-defined labels는 schema flexibility를 준다.
하지만 새로운 업무의 semantic boundary를 제대로 배우려면 여전히 학습 데이터가 필요할 수 있다.
3. 긴 문서의 confidence는 더 조심해야 한다
현재 Laya에는 긴 문서를 여러 window로 나눠 처리하는 predict_long도 있다.
그런데 코드 주석은 이 경우 선택된 window의 probability를 문서 전체의 calibrated probability로 해석하면 안 된다고 명시한다.
여러 window 중 최대값이나 가장 confident한 window를 고르는 aggregation 자체가 기존 calibration 가정을 바꾸기 때문이다.
결국 어느 모델이든 confidence는 그냥 숫자 하나 받아서 믿는 문제가 아니었다.
그 숫자가 어떤 데이터, 어떤 aggregation, 어떤 calibration procedure에서 나온 것인지까지 알아야 한다.
다시 Jev로 돌아오면, 무엇을 알게 된 걸까?
Laya를 꽤 깊게 봤지만 Jev의 내부를 알아낸 것은 아니다.
Jev에 대해 TypeSafe가 공식적으로 공개한 것은 현재 다음 정도다.
- 생성 대신 typed probabilistic decision을 반환한다.
- 새로운 model architecture를 사용한다고 설명한다.
- parallel sampler를 사용한다고 설명한다.
- 학습 방향을 RLCD라고 부른다.
- calibration된 decision probability를 중요한 목표로 둔다.
반면 다음과 같은 것은 공개된 정보만으로 단정할 수 없다.
- ModernBERT 같은 bidirectional encoder를 쓰는가?
- [MASK] option marker를 사용하는가?
- 각 option에 같은 scalar scorer를 적용하는가?
- Laya와 같은 proper scoring rule 조합을 쓰는가?
- RLCD에서 REINFORCE나 Gaussian logit exploration을 쓰는가?
모른다.
그래서 이 글에서 Laya가 해준 역할은 Jev를 역공학하는 것이 아니다.
Decision Model이라는 조금 추상적인 개념을
runtime options
→ bidirectional encoding
→ marker scoring
→ option logits
→ calibrated probability
라는 실제로 동작하는 하나의 구현 사례로 볼 수 있게 해준 것이다.
결국 LLM과 Decision Model은 무엇이 다른가?
처음에는 이렇게 이해했다.
LLM
→ 문장을 생성한다

Decision Model
→ 판단한다
코드까지 내려가 보니 조금 더 정확하게 말할 수 있게 됐다.
LLM에서는 기본적으로
다음 vocabulary token에 대한 probability distribution
을 계속 예측한다.
Laya에서는
현재 요청에서 정의된 option들에 대한 probability distribution
을 직접 만든다.
그리고 그것을 가능하게 하기 위해 Laya는
- class definition을 output head가 아니라 input으로 옮기고,
- bidirectional encoder가 question, options, state를 함께 읽고,
- 각 option marker에 동일한 scorer를 적용하고,
- probability distribution 자체가 의미를 갖도록 학습한다.
지난 글에서 내가 가장 궁금했던 것은
Classifier의 효율성과 LLM의 유연성을 어떻게 동시에 가져갈 수 있을까?
였다.
Laya가 그 문제에 내놓은 답은 꽤 명확했다.
고정된 class head를 버리고, 선택지를 언어로 입력한 다음 그 선택지들을 직접 점수화한다.
물론 이 방식도 공짜는 아니다.
option 수가 context budget을 먹고, domain adaptation이 필요할 수 있고, calibration도 실제 운영 데이터에서 다시 검증해야 한다.
그래도 코드를 보고 나니 Decision AI를 단순히 "LLM보다 빠른 분류 모델"이라고 생각하기는 어려워졌다.
내게는 오히려 예측해야 하는 확률분포의 공간을 다시 설계한 모델에 더 가깝게 느껴졌다.
마치며
이번에 가장 크게 남은 것은 모델의 크기나 benchmark 숫자가 아니었다.
모델이 무엇을 예측하도록 만들었는가?
그리고 무엇을 잘했을 때 reward를 주고 있는가?
이 두 질문이었다.
LLM은 언어의 다음 token을 예측하는 능력에서 출발해 사람에게 유용한 응답을 만드는 방향으로 발전해왔다.
Laya 같은 Decision Model은 아예 출력 공간을 typed option으로 제한하고, 그 option에 대한 probability 자체를 소프트웨어가 사용할 수 있는 값으로 만드는 방향을 시도한다.
결국 지난 글에서 이야기했던 모델 선택보다 모델 배치가 중요할 수도 있다는 생각도 조금 더 구체적으로 바뀌었다.
어떤 단계에는 자유로운 언어 생성이 필요하다.
어떤 단계에는 긴 reasoning이 필요하다.
하지만 어떤 단계에는
A인가?
B인가?
C인가?

그리고 얼마나 확신하는가?
만 필요하다.
그렇다면 그 단계에 굳이 다음 token을 계속 생성하는 모델을 배치해야 하는지도 다시 물어볼 수 있다.
Decision Model이 앞으로 얼마나 널리 쓰이게 될지는 아직 모르겠다.
하지만 적어도 이제는 지난 글에서 봤던 Classifier와 LLM 사이의 빈자리가 단순한 개념적 빈칸이 아니라, 모델 아키텍처와 학습 목표의 수준에서도 실제로 탐구할 만한 공간이라는 생각이 든다.
참고 자료
- Classifier와 LLM 사이의 빈자리 — Jev를 통해 다시 생각한 AI의 판단
- TypeSafe AI — Introducing System One Models & Jev
- Laya — GitHub
- Laya common.py — sequence / architecture / proper scoring rule
- Laya agent.py — inference / temperature / typed result decoding
- Laya 0.3.21 — PyPI
- Laya Typed-Decisions — Hugging Face
- ModernBERT Paper — ACL 2025
- OpenAI — Aligning language models to follow instructions